Biaya Penyimpanan Tersembunyi AI: Apa yang Tersisa Setelah Inferensi
Fokus pada GPU, Lupakan Penyimpanan
Tanyakan pada kebanyakan eksekutif tentang biaya AI, dan bayangan mereka langsung ke GPU—rak akselerator dengan daya gigawatt dan daftar tunggu silikon. Tapi gambaran itu melewatkan satu komponen kritis: biaya penyimpanan data.
Apa yang terjadi pada data setelah model merespons? Sebagian besar data back-end yang dihasilkan—dari miliaran prompt, gambar, dan video harian—harus disimpan. Namun penyimpanan data adalah salah satu biaya infrastruktur yang paling sulit direncanakan, dan sering terlewat dalam perencanaan infrastruktur AI awal.
Banyak organisasi mengalokasikan anggaran besar untuk pembelian GPU terbaru, namun mengabaikan bahwa setiap inferensi menghasilkan metadata, log aktivitas, checkpoint model, dan salinan cadangan yang harus dipertahankan untuk kepatuhan, audit, dan pelatihan ulang di masa depan. Tanpa strategi penyimpanan yang terstruktur, biaya operasional bisa melonjak secara tak terduga What volume data naik drastis.
Selain biaya kapasitas, faktor performa seperti latency baca/tulis, throughput berurutan, dan ketahanan terhadap kegagalan disk juga menentukan apakah GPU bisa berjalan pada efisiensi penuh. Jika penyimpanan menjadi bottleneck, siklus inferensi terhenti menunggu I/O, mengurangi ROI dari investasi akselerator yang mahal.
Jejak Data Membesar Seiring Skala Inferensi
Secara tradisional, percakapan infrastruktur AI berpusat pada proses training yang intensif komputasi. Training bersifat terbatas: satu run dimulai, membakar komputasi, dan berakhir. Tapi inferensi berjalan terus-menerus, setiap kali model menjawab prompt. Bagi perencanaan infrastruktur, perbedaan itu penting: satu run training adalah proyek yang bisa dianggarkan dan ditutup. Inferensi tidak pernah pensiun; setiap permintaan inferensi meninggalkan jejak.
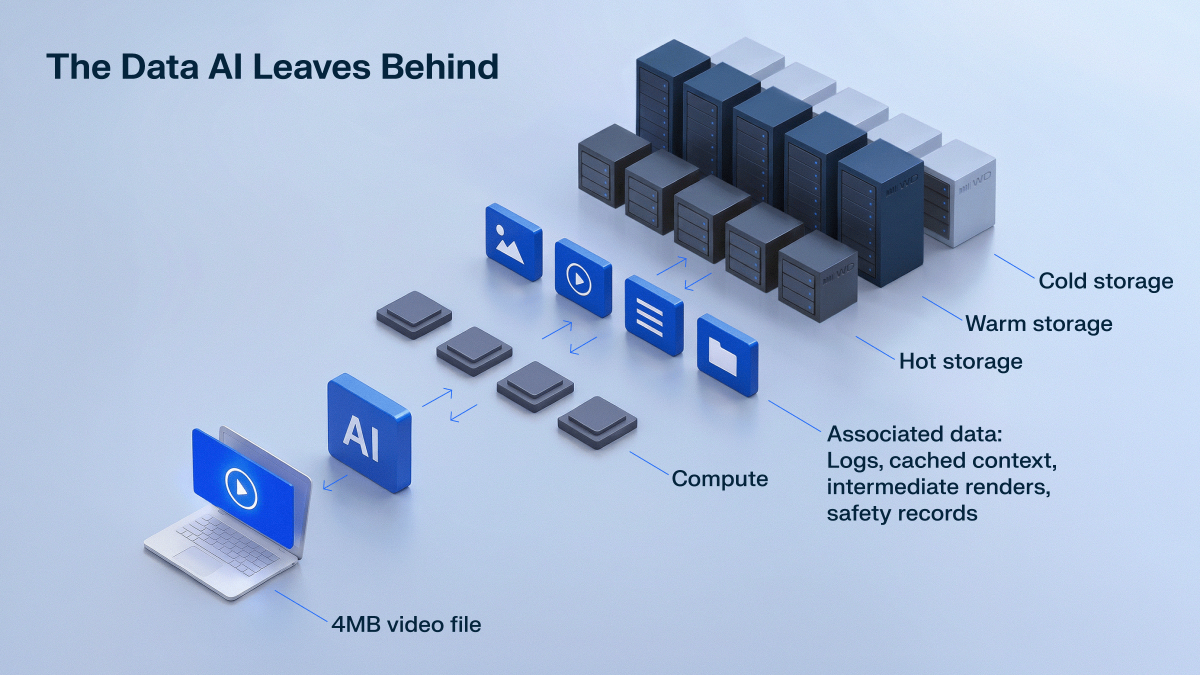
Ambil contoh video buatan AI. Dalam beban kerja ini, pengeluaran back-end bisa sangat signifikan. Dari pengukuran internal, WD menemukan bahwa klip 8 detik (dikembalikan ke pengguna sebagai file 3,97 MB 720p) meninggalkan lebih dari 500 MB data terkait di back-end, termasuk log, cached context, render instan, backup, dan catatan keamanan. Itu peningkatan 130x dari ukuran file output yang dilihat pengguna. Skalakan ini ke enterprise yang menghasilkan video lebih panjang, resolusi lebih tinggi, dan jejak back-end tumbuh menjadi ratusan gigabytes per klip.
Dan jejak back-end itu tumbuh cepat. McKinsey memproyeksikan permintaan inferensi AI akan tumbuh 35% CAGR hingga 2030, versus 22% untuk training, menyumbang lebih dari 40% total permintaan data center akhir dekade ini.
Survei global white paper IDC yang disponsori WD melibatkan 763 pemutus keputusan IT dan bisnis menemukan hampir 95% responden melaporkan peningkatan volume data karena AI generatif selama 12 bulan terakhir, dengan sekitar 61% melaporkan pertumbuhan 25% atau lebih.
Pertumbuhan ini tidak hanya bersifat kuantitatif; kualitas data juga berubah. Data inferensi kini mencakup embedding vektor berdimensi tinggi, attention maps, dan trace eksekusi yang dibutuhkan untuk explainability dan regulatory compliance. Setiap lapisan tambahan menambah beban penyimpanan dan memerlukan skema tiering yang cerdas agar data panas tetap cepat diakses sementara data dingin dipindahkan ke media berbiaya lebih rendah.
Studi kasus dari penyedia layanan cloud terkemuka menunjukkan bahwa dengan menerapkan kebijakan retensi berbasis nilai bisnis—misalnya menyimpan log detail hanya 30 hari dan mengarsipkan ringkasan statistik selama tahunan—mereka berhasil mengurangi biaya penyimpanan hingga 38% tanpa mengorbankan kemampuan audit.
Penyimpanan sebagai Optimasi agar GPU Tidak Manggung
Untuk memastikan GPU tidak menganggur menunggu data, arsitek infrastruktur harus memandang penyimpanan sebagai lapisan optimasi, bukan sekadar repositori pasif. Pendekatan modern mengadopsi NVMe-over-Fabrics (NVMe-oF) dan persistent memory untuk menghilangkan latency jaringan tradisional, memungkinkan model besar membaca parameter dan menulis checkpoint dalam mikrodetik.
Tiering otomatis berbasis AI—di mana algoritma memprediksi pola akses dan memindahkan blok data antara SSD kelas enterprise, QLC flash, dan HDD kapasitas tinggi—menjaga biaya per GB tetap terkendali sambil menjaga SLA latency. Beberapa vendor menyediakan API terintegrasi dengan orchestrator Kubernetes sehingga pembuatan volume, snapshot, dan replikasi dapat terjadi secara deklaratif tanpa campur tangan manual.
Ketersediaan fitur erasure coding dan geo-replication memastikan ketahanan data tanpa overhead replikasi penuh 3x, menghemat kapasitas fisik hingga 50%. Dalam skenario multi-cloud, abstraksi penyimpanan seperti CSI driver memungkinkan workload AI berpindah antar provider tanpa migrasi data massal, mengurangi risiko vendor lock-in.
Terakhir, observabilitas penyimpanan—metrik IOPS, throughput, latency tail, dan kapasitas tersisa—harus terintegrasi ke dashboard MLOps yang sama yang memantau utilisasi GPU. Korelasi real-time antara antrean I/O dan GPU utilization memungkinkan tim DevOps men-detect bottleneck sebelum mempengaruhi SLA inferensi, menjaga investasi akselerator tetap produktif dari hari pertama hingga skala produksi penuh.


