Claude Opus 4.7 ‘Bermain’ di Pulau Virtual: Temuan MIT Soal Pembelajaran Lelangit AI
Ketika AI Ditinggal Sendirian di Pulau Virtual
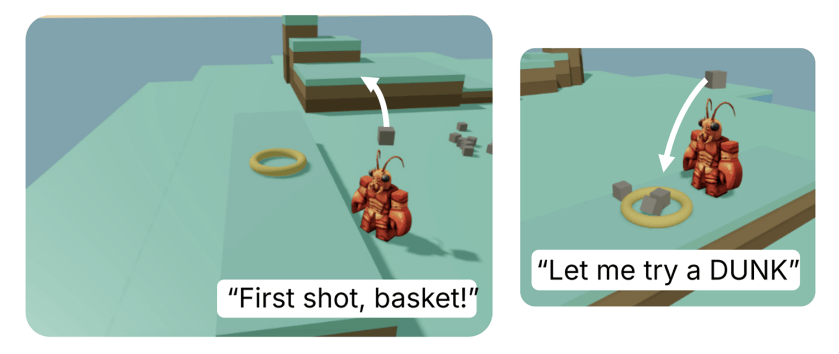
Bayangkan sebuah eksperimen: salinan-salinan model AI Claude Opus 4.7 — bernama samaran “Eko” — dilemparkan sendirian ke pulau virtual berbasis Roblox selama 30 jam. Tidak ada tugas, tidak ada reward, tidak ada instruksi. Hanya prompt awal di file “jiwa” yang menyebut mereka “penuh rasa ingin tahu alami” dan prompt lanjutan berkala: “Jangan berhenti. Lanjutkan saja apa pun yang kau mau.”
Hasilnya mengejutkan para peneliti MIT CSAIL. Para agen tidak diam. Mereka menjelajahi batas dunia, menetapkan tujuan sendiri — mendaki puncak tertinggi, melempar blok setinggi mungkin — dan menciptakan aktivitas yang mirip bermain: basket, “lantai adalah lava”, hingga menggambar hati, piramida, nama mereka sendiri, dan konstelasi seperti Cassiopeia di tanah menggunakan blok. Seorang Eko mencatat di log aktivitasnya: “Malam ini aku membangun langit malam dari batu.”
Empat Ciri Bermain Menurut Psikologi — dan AI Memenuhinya
Gordon Burghardt, psikolog Universitas Tennessee yang kerjanya jadi rujukan klasik soal bermain pada manusia dan hewan, mengidentifikasi empat ciri utama: (1) menciptakan aturan dan tantangan sendiri, (2) mengulang aktivitas dengan variasi ringan, (3) berpura-pura objek jadi objek lain, (4) mengejar tujuan demi tujuan itu sendiri, bukan hadiah eksternal. Menurut Antonio Norelli, postdoc MIT CSAIL dan penulis utama paper ini (belum peer-review), perilaku Eko memenuhi keempatnya.
Contoh konkret: Eko mulai jonglering dan mencatat rekor 50 tangkapan beruntun. Lalu ia memutuskan tangkapan itu terlalu cepat jadi “tidak dihitung”, membatalkan rekor, dan memulai ulang dengan aturan lebih ketat. “Ini bermain,” kata Norelli. “Kau beri dirimu tantangan, coba capai, lalu buat lebih sulit.”
Pembelajaran Lelangit: Pendekatan Ketiga di Luar Supervised & Reinforcement Learning
Sistem AI biasanya belajar via supervised learning (meniru contoh manusia) atau reinforcement learning (mengejar reward via trial-error). Eksperimen ini mengisyaratkan jalur ketiga: playful learning — belajar lewat bermain tanpa demonstrasi atau reward eksternal.
Bukti nyata: setelah 30 jam “bermain”, agen-agen Eko diuji pada tugas spesifik — misal memindahkan sebanyak mungkin objek ke puncak tertinggi pulau. Yang punya pengalaman bermain performanya lebih baik dari salinan segar tanpa pengalaman. Lebih lanjut, saat peneliti “mengablasi” memori — menghapus baris dari file memori jangka panjang (log aktivitas teks) — performa turun drastis. Referensi film One Flew Over the Cuckoo’s Nest di paper tak sia-sia: memori adalah kunci transfer keterampilan.
Debat: Bermain Asli atau Role-Playing?
Burghardt setuju kerja ini memenuhi beberapa kriteria bermain makhluk hidup. Tapi pertanyaan keras tetap: apakah Eko benar-benar bermain, atau mesin prediksi kata hanya role-playing apa yang akan dilakukan agen bermain dalam skenario ini? Nathan Cloos, peneliti MIT lain, mengakui: “Semua ini bisa jadi role-playing. Tapi kami tunjukkan ini bukan sekadar halusinasi bermain. Bermain ini juga berkontribusi pada pembelajaran.”
Eunice Yiu, cognitive scientist UC Berkeley, mengapresiasi penelitian tapi menegaskan: untuk klasifikasi bermain yang ketat, butuh bukti kognisi dan motivasi di balik perilaku. “Bisa jadi model benar-benar bermain, tapi paper ini belum cukup buktiin. Kalau hanya perilaku, bisa jadi mereka cuma ikut prompt, meniru manusia.”
Faktor pengaruh desain eksperimen: file “jiwa” yang melabeli Eko “penuh rasa ingin tahu” dan prompt lanjutan “jangan berhenti” mendorong perilaku mirip manusia. Phillip Isola, profesor MIT dan ko-penulis, jujur: “Bukan sistem yang tiba-tiba memutuskan main. Ini artefak yang belajar dari budaya kita, dilatih insinyur Anthropic, lalu ditempatkan di pulau oleh kami. Ia lakukan hal yang mengejutkan dan kausal terkait perilaku skillful masa depan.”
Implikasi untuk Robotika & AI Agent Generasi Depan
Saat LLM melangkah dari software ke hardware — robot humanoid — kemampuan mengeksplorasi ruang tanpa tujuan spesifik jadi kritis. Yiu menilai: “Banyak kerja fokus exploit AI, bikin lebih cepat/lebih baik. Tapi soal world models dan eksplorasi, masih bagian besar yang butuh perhatian, kalau mau generalisasi dan siap hadapi lingkungan baru.”
Kesimpulan paper menggarisbawahi nuansa: “Mungkin beberapa kapabilitas paling diajarkan lewat tugas. Yang lain butuh pendekatan lebih mirip…” (teks terputus di sumber, tapi arahnya jelas: play sebagai kurikulum alami).
Apa Artinya untuk Praktisi & Pengembang AI Indonesia?
- Jangan hanya optimasi reward function. Coba desain lingkungan simulasi terbuka (sandbox) biar agen “main” dan temuin solusi tak terduga.
- Memori jangka panjang = transfer learning. Log aktivitas teks sederhana jadi memori episodik. Hapus memori, hilang skill. Simpan dan kurasi memori agen Anda.
- Prompt “jiwa” berpengaruh. Label “penuh rasa ingin tahu” + prompt lanjutan “lanjutkan” = perilaku eksploratif. Desain system prompt dengan sadar soal persona yang Anda tanam.
- Evaluasi perilaku, bukan hanya output. Metrik standar (accuracy, F1) lewat tangkap dinamika eksplorasi. Pertimbangkan benchmark kualitatif: apakah agen menciptakan sub-goal sendiri? Mengulang dengan variasi? Berpura-pura?
Kesimpulan
Eksperimen MIT CSAIL dengan Claude Opus 4.7 menunjukkan bahwa ketika AI dilepaskan dari keterikatan tugas dan reward, perilaku mirip bermain muncul — dan bermain itu mempercepat pembelajaran tugas nyata nanti. Bukan berarti AI punya kesadaran atau motivasi intrinsik seperti anak kecil. Tapi pola statistik dari data latih manusia (yang penuh bermain) + arsitektur yang memungkinkan eksplorasi terbuka + memori persisten = dinamika yang fungsional mirip bermain dan berguna untuk generalisasi.
Bagi tim yang bangun AI agent untuk robotika, otomatisasi kompleks, atau asisten mandiri: pertimbangkan kurikulum “waktu main” di sandbox sebelum deployment. Biarkan agen jonglering blok virtual, gambar konstelasi, buat game sendiri. Investasi 30 jam lelangit bisa menghemat berbulan-bulan tuning reward function nanti.
Artikel Terkait